Diseñé de punta a punta los agentes de IA para BPOs de Silia: contact centers que atienden, cobran y venden por teléfono y chat.
Resumen y rol
Silia, plataforma de agentes de IA para operaciones. Área de BPOs: contact centers que atienden, cobran y venden por teléfono y chat. En producción en 139 centros de trabajo.
Un Product Manager y yo, como única Product Designer del área de BPOs.
Investigación de campo, síntesis, arquitectura, flujos, UI y prototipo funcional de QA, Coach y RTA. En el agente Custom aporté cerca del 20 %.
El resultado en una línea
de las llamadas evaluadas, a mano, en Google Forms
de las llamadas evaluadas hoy, con 60 % menos analistas
Empezó como piloto en 5 sucursales. Hoy opera en 139 centros de trabajo, y cada uno fija su meta de revisión según su presupuesto.
El desafío
Un contact center vive de miles de llamadas, y casi ninguna se escuchaba.
QA trabajaba con Google Forms y un proceso manual. Revisar el 2 % ya costaba mucho trabajo.
Se entrenaba en vivo, igual para todos, sin conexión con cómo le iba a cada asesor.
En una llamada difícil todo dependía de la pericia del operador. Nadie lo apoyaba en el momento.
Empatizar
Fuimos a ver cómo se trabaja de verdad.
países
Colombia, Chile y Argentina
call centers
Visitas presenciales a la operación
perfiles
Operadores, analistas de calidad e instructores de onboarding
Revisamos sus procesos y los entrevistamos para encontrar dónde estaba la fricción. Todas las decisiones de diseño que siguen salieron de ahí.
Síntesis reconstruida para este caso; los entregables originales son confidenciales del proyecto.
Tres personas, tres frustraciones distintas
Quiere resolver bien la llamada y cerrar la negociación. Le duele estar solo en las llamadas difíciles y recibir retroalimentación tarde y genérica.
Quiere evaluar con criterio y de forma justa. Le duele escuchar llamada por llamada y capturar en Google Forms: solo alcanza al 2 %.
Quiere que cada asesor mejore justo donde falla. Le duele entrenar en vivo, igual para todos y sin datos de desempeño.
Proto-personas construidas a partir de las entrevistas en campo.
Definir
El ciclo estaba roto en cada etapa.
- 1 · Llamada
AntesDepende solo de la pericia del asesor.
OportunidadRTA: consejos en el momento.
- 2 · Evaluación
AntesManual, en Google Forms. Solo el 2 %.
OportunidadQA: evaluar a escala.
- 3 · Feedback
AntesLlega tarde, o nunca, al asesor.
OportunidadQA: el asesor ve su evaluación.
- 4 · Entrenamiento
AntesEn vivo y genérico, igual para todos.
OportunidadCoach: plan según su calificación.
- 5 · Desempeño
AntesInvisible: no se sabe quién necesita ayuda.
OportunidadDatos: todos medidos igual.
Journey basado en las entrevistas y la revisión de procesos en campo.
¿Cómo podríamos medir la calidad en todas las llamadas, entrenar a cada asesor en lo que de verdad le falla y que nadie enfrente solo una llamada difícil?
El cuello de botella no es el criterio del analista, es su tiempo.
Evaluar y entrenar vivían separados, aunque son el mismo dato.
La ayuda llega después de la llamada, cuando ya no sirve.
Idear
Un ciclo, no tres herramientas
Asiste al asesor en vivo con objetivos y sugerencias.
Evalúa a escala y sube lo que pide criterio humano.
Entrena con base en la calificación de QA.
El asesor vuelve a llamar con lo que practicó.
Cuatro reglas que guiaron cada pantalla
- La persona revisa solo lo que pide criterio
- Penalizaciones graves (auto zero) y casos donde la IA tuvo dudas.
- El costo se decide, no se sufre
- Analizar el 100 % o un filtro, con un tope de consumo visible.
- La IA aprende de las personas
- Con muestras en Calibrate, el criterio humano corrige al sistema.
- El asesor ve lo mismo que su evaluador
- Sus evaluaciones y llamadas difíciles están a su alcance para mejorar.
Primero la estructura, después el detalle
Wireframes de baja fidelidad redibujados para este caso a partir de las pantallas finales.
QA Agent
Evalúa a escala las llamadas que antes se muestreaban a mano, y lleva al analista solo a donde su criterio hace falta.
Seis módulos, cada uno resuelve una parte
- Inbox
- Llamadas evaluadas, auto zero y muestreo: lo que necesita a una persona.
- Source y Sampling
- De dónde llega el audio (carga, SFTP o captura) y qué parte se analiza.
- Knowledge Base
- Políticas y procedimientos contra los que se califica cada pregunta.
- Evaluations
- Power Skills, scorecard y auto zero: cómo una llamada se vuelve nota.
- Calibration
- Analistas califican a ciegas; donde difieren de la IA, se propone un criterio nuevo.
- Settings
- Agente, accesos, cobro con tope de consumo y registro de cambios.
Crear un evaluador en cinco pasos, sin configurar de más
Pasos: General · Score · Knowledge Base · Access · Location
El humano revisa lo que importa
La IA evalúa toda la muestra. A la bandeja llegan sobre todo dos tipos de caso:
- Auto zero: una falta grave anula la nota.
- IA con dudas: no entendió algo de la llamada.
El 100 % es posible; cada centro elige su meta
En producción, ningún centro pidió el 100 %: las metas quedaron entre 20 % y 30 %.
Cada vez más inteligente
Los analistas califican a ciegas las mismas llamadas que la IA. Donde no coinciden, el sistema propone una nueva redacción del criterio. Así las brechas de la plataforma se balancean solas, con muestras.
Coach AI
Entrena a cada asesor con clientes simulados por IA, y puede calificarlo con la misma regla de su QA Agent.
Practicar y evaluar son dos caras del mismo ciclo
- Inbox
- Cada práctica evaluada: nota, auto zero y qué mejorar. Desde aquí, el Do-over.
- Practice
- Habla con el agente que actúa de cliente; se evalúa al momento.
- Knowledge Base
- Políticas y procedimientos contra los que se califica.
- Evaluations
- Power Skills, scorecard y auto zero, propios o los de un QA Agent.
- Calibration
- El mismo módulo que en QA: el criterio humano corrige a la IA.
- Skills
- El cliente simulado de cada tipo de llamada y cómo actúa en cada dificultad.
- Settings
- Práctica, calificación, progreso, retención y voz del cliente simulado.
QA y Coach hablan el mismo idioma
Al crear un Coach se elige su forma de calificar: con evaluaciones propias o con las de un QA Agent que ya evalúa a los operadores reales. Así el entrenamiento se planea sobre lo que de verdad le falla a cada asesor.
Pasos: General · Scoring · Knowledge Base · Access · Location
La llamada difícil se puede volver a hacer
Entrenamiento constante, no un evento
El instructor ve dónde está cada asesor, cómo evolucionan sus últimas calificaciones y cuántos do-overs usó. El plan se ajusta con cada evaluación nueva.
RTA
Real Time Assistant: entra a dar consejos en el momento de la llamada, en un widget de escritorio.
Ocho módulos para guiar, medir y mejorar
- Inbox
- Llamadas con transcripción, apego a lineamientos, temas y emoción.
- Processes
- Árbol de procesos, lineamientos y guiones que sigue en cada llamada.
- Knowledge Base
- Documentos fuente que se procesan y se suman a los procesos.
- Versiones
- Borradores, versión activa y archivadas: activar o revertir.
- Metrics
- Resolución, tiempo de atención y adopción de sugerencias.
- Team schedule
- Horario esperado vs. uso real: señala la brecha, no juzga.
- Evals
- Prueba la calidad de la guía antes y después de lanzar.
- Settings
- Configuración, disparadores y base conversacional.
El cliente sube sus guiones; la IA arma los procesos
Pasos: Upload · Verify · Location
Lo que el asistente sabe, y cómo le va
Las cifras de la pantalla son datos de demostración del prototipo.
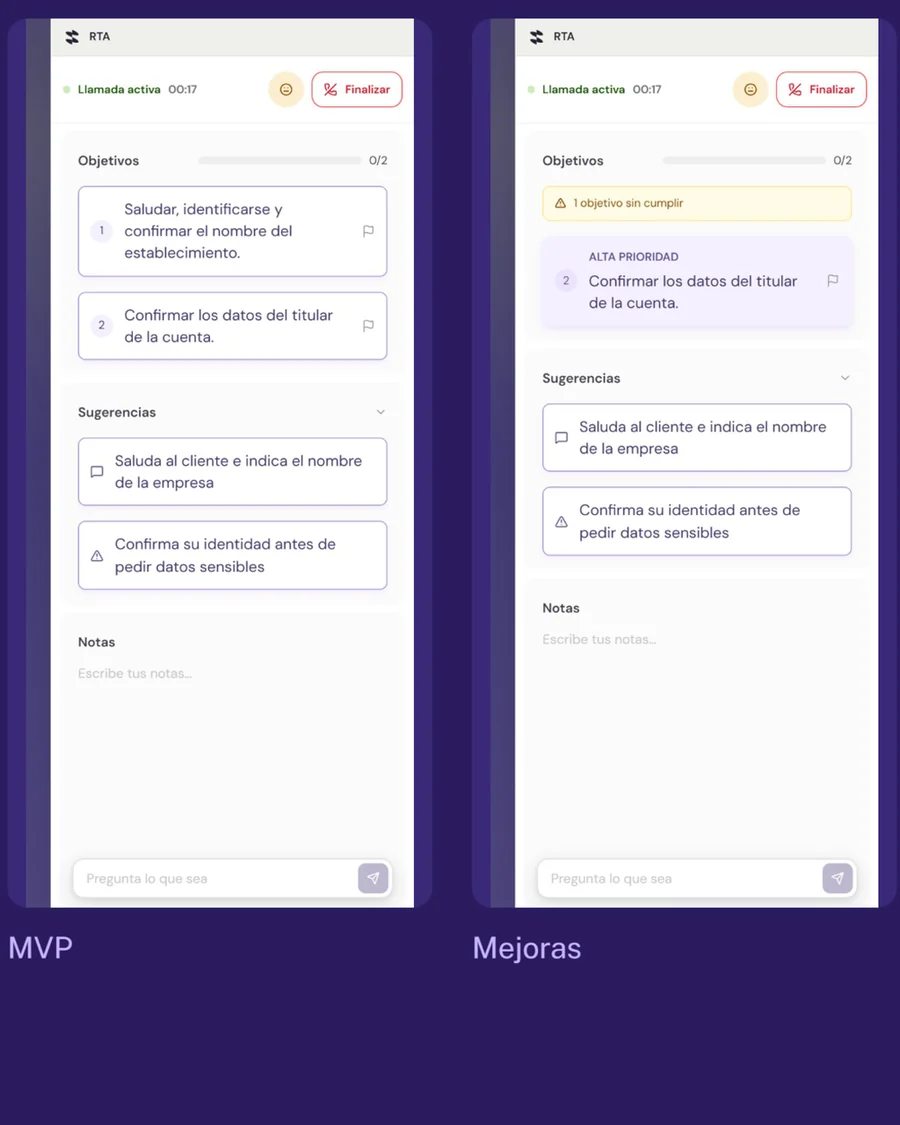
Dos widgets, dos trabajos: uno propone, el otro califica
Ayuda en el momento, sin quitarle la atención al cliente
- Objetivos que aparecen según avanza la llamada.
- Sugerencias para el momento exacto.
- Notas y un asistente al que se le pregunta lo que sea.
- Alertas de alta prioridad y objetivos sin cumplir.
Agente Custom
Un agente que se configura para hacer lo que necesites: crear un proceso, revisar el correo, o encadenarle voz para contestar llamadas de una tienda con un RAG de sus productos.
Mi participación aproximada en su diseño fue del 20 %. Fuera de mi área; lo menciono como contexto de la plataforma.
Mapa del ecosistema
Todo junto, en un diagrama. Los tres agentes se alimentan de la misma Knowledge Base: guiones, políticas y procesos.
Anatomía de los agentes
Cada paso y cada módulo, del wizard al resultado. Dos diagramas por agente: cómo se crea y configura, y cómo opera día a día. Se leen de izquierda a derecha.
QA Agent · Crear y configurar
QA Agent · Operar
Coach AI · Crear y configurar
Coach AI · Operar
RTA · Crear y mantener
RTA · Operar
Cómo trabajamos
Cambiamos el handoff por un prototipo funcional
Figma → Front → Back. Cada pantalla se reinterpretaba en el handoff.
DS de Figma (una vez) → Claude Code + React → Prototipo funcional → Revisión de front.
Figma dejó de ser parte del handoff: hoy documenta la evolución del sistema. Se valida con algo que funciona, no con imágenes.
Un sistema que no se lee: se toca
El design system ya existía en Figma. Lo transformamos a componentes de React, y sus reglas viven en un documento que se renderiza y se audita. Un solo lugar de verdad: el código.
Impacto
Del piloto a 139 centros de trabajo.
Meta de llamadas evaluadas: de 10 a 15 veces más cobertura de calidad.
Analistas de calidad necesarios para cubrir esa meta mayor.
Del piloto en 5 sucursales a 139 centros de trabajo en producción.
Con RTA en vivo, los centros reportaron negociaciones más exitosas.
Lo siguiente a medir: acuerdo IA-analista en Calibrate · adopción de sugerencias RTA · mejora tras do-over.
Lo que me llevo
Lo pone donde su juicio aporta: las faltas graves y las dudas.
Calibración, procesos visibles y que el asesor vea su propia evaluación.
Validar con algo que funciona acorta la distancia entre diseño y producto.
Diseñar IA en la que la gente confíe.